13 أكتوبر 2026، المساء الذي أُتيح فيه Gemini 4 Argon للجميع
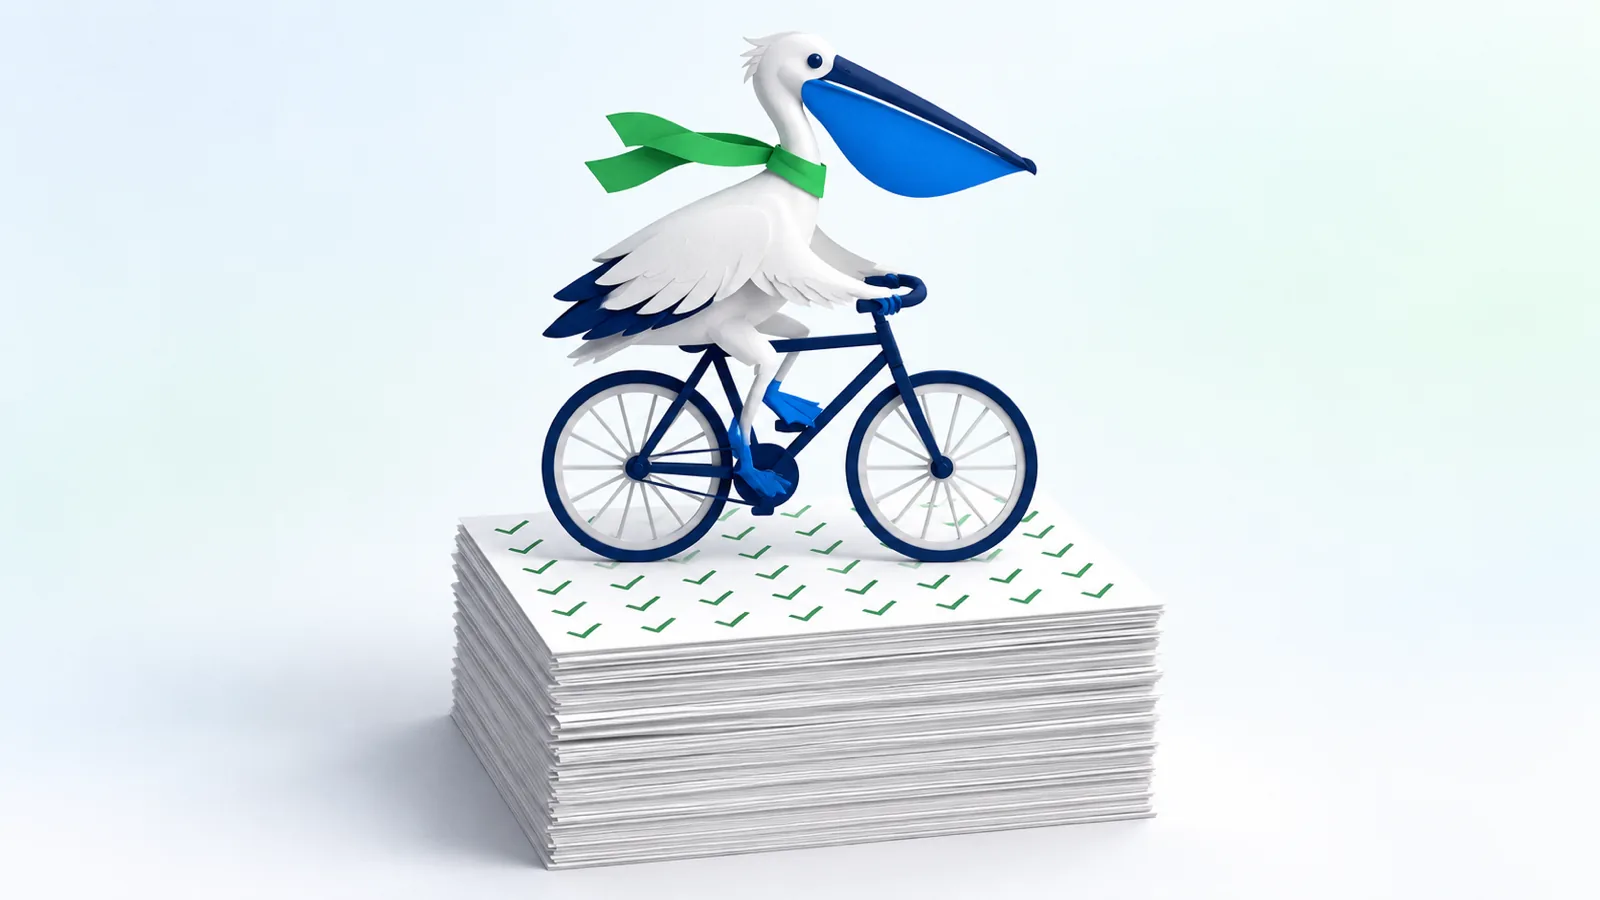
Simon Willison، مطوّر يعطي كل نموذج جديد المهمة نفسها، يطلب من Argon أن يرسم طائر بجع يركب دراجة هوائية. يحصل على ثلاث رسمات ويصفها كلها بأنها "ممتازة": هيكل دراجة دقيق، وسمكة في السلة، ووشاح، وقدمان على الدوّاسات.
في المساء نفسه، مصمم واجهات اختبر Argon على البرمجة وعلى عمل الوكلاء يلخّص رأيه في سطر واحد: Opus 5.5، يليه GPT-6 Astra، ثم Argon بعدهما.
رسمة البجع ممتازة وكلّفت 17 سنتًا. أما في المهام التي تدفع الشركة مقابلها، مثل برمجة موقع، فالترتيب مختلف.
Gemini 4 Argon هو أقوى نموذج أطلقته Google حتى اليوم. أُعلن عنه في 30 سبتمبر، وأُتيح للجميع في 13 أكتوبر. في الجدول الذي نشرته Google ينال أعلى درجة في 13 اختبارًا من أصل 19، وأمام Claude Opus 5.5، النموذج الذي يتصدّر اليوم المؤشرات المستقلة، يفوز في 14 من أصل 18.
أعمل مع نماذج Anthropic وOpenAI وGoogle كل يوم، ومنذ الإطلاق تابعت ثلاثة أنواع من الأدلة: جدول Google، واختبارات جهات مستقلة، وتجارب مطوّرين شغّلوا المهمة نفسها على Argon وعلى Opus. لم أشغّل Argon بنفسي على مهام لعملاء. وعلى امتداد المقال أبيّن ما هو حقيقة وما هو رأيي.
باختصار
- Gemini 4 Argon قفزة حقيقية لـGoogle، لكنه ليس النموذج الأول. في المؤشر المستقل لـArtificial Analysis ينال 53، مثل GPT-6 Astra، مقابل 58 لـClaude Opus 5.5.
- أرخص بكثير، حتى الآن. المهمة المتوسطة تكلّف فيه نحو ثلث ما تكلّفه في Opus 5.5، وفي بعض تجارب البناء المرئي أقل من الخُمس. ابتداءً من 1 ديسمبر يتضاعف سعر التوكن ويتساوى مع Opus.
- شبهة benchmaxxing، أي نموذج دُرّب ليتفوّق تحديدًا في الاختبارات المعروفة. في جدول Google يتصدّر Argon. وفي اثنين من أربعة اختبارات برمجة جديدة هو في المستوى الذي بلغته النماذج الرائدة في يوليو، وفي اثنين في مستوى سبتمبر.
- رأيي: نموذج جيد وفعّال، خصوصًا للكتابة، وللغات غير الإنجليزية، وللمستندات، وللمهام التجارية المحددة. أما البرمجة والعمل الذي تكون الجودة فيه هي المنتج، فـOpus 5.5 ما زال متقدمًا عليه.
ما هو Gemini 4 Argon، ولماذا استغرق فتحه أسبوعين
Argon هو النموذج الكبير في عائلة Gemini 4، وهو مخصص لأصعب مهام التفكير. وإلى جانبه تشغّل Google نماذج منفصلة: Gemini 3.8 Flash للسرعة، وNano Banana للصور، وOmni Flash وGemini 3.8 TTS للصوت، وLyria للموسيقى. حتى الآن كان أقوى نموذج لدى Google هو Gemini 3.1 Pro، أما الإصدار 3.5 Pro الذي وُعد به في يونيو فأُلغي في الطريق.
في 30 سبتمبر أعلنت Google عن Argon، لكنها فتحته فقط لمجموعة مغلقة من المدافعين في مجال الأمن السيبراني، ضمن برنامج اسمه Fairwind. وفي 13 أكتوبر، بعد 13 يومًا، أُتيح للجميع:
المصادر: إعلانات الإطلاق من Google (30 سبتمبر و13 أكتوبر)، وقائمة أسعار Gemini API، وصفحة النموذج للمطوّرين. إن لم يكن المصطلح مألوفًا، فقد شرحنا ما هو التوكن في مقال منفصل.
أين يمكن استخدامه اليوم:
- في تطبيق Gemini: لمشتركي Google AI Pro وUltra. المستخدمون المجانيون لا يحصلون عليه.
- عبر API، أي الربط المباشر للمطوّرين والأنظمة: في الباقة المدفوعة فقط. لا توجد باقة مجانية.
- في أداة البرمجة من Google، Antigravity: لمشتركي Ultra فقط.
التفسير الرسمي للتأخير هو السلامة. كتبت Google أن الإطلاق على مراحل ضروري لإتاحة قدرات بهذا المستوى بأمان، وشاركت في برنامج طوعي لحكومة الولايات المتحدة يحصل على وصول مبكر إلى النماذج. وفي وثيقة النموذج تذكر أنها لا تستطيع أن تستبعد أن Argon تجاوز العتبة الحرجة التي حددتها لقدرات الأمن السيبراني. أما رأيي في التأخير، ففي قسم الرأي.
أمر واحد يجدر معرفته قبل المتابعة: Argon نفسه يُخرج نصًا فقط. في عروض Google جاءت الصور من Nano Banana، وأصوات المحرك من Omni Flash، والتعليق الصوتي من Gemini 3.8 TTS، والموسيقى من Lyria. Argon ينسّق بينها ويكتب الكود. قوة Google في توليد الصور والفيديو والتصميم هي قوة العائلة كلها، لا قوة نموذج واحد.
جدول Google: 13 فوزًا من أصل 19
نشرت Google جدولًا من 19 اختبارًا، يظهر فيه Argon أمام ثلاثة منافسين: GPT-6 Astra من OpenAI، وClaude Fable 5.1 وClaude Opus 5.5 من Anthropic. في كل صف الدرجة الأعلى مميّزة بالأخضر، ووسم يميّز الصفوف التي شغّلت فيها Google نموذج Argon بنفسها:
الجدول الذي نشرته Google، بالعربية: درجة كل نموذج في كل اختبار
| الاختبار | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| العمل المهني | ||||
| مؤشر العمل المهنيVals Index | 68.9 | 63.1 | 65.8 | 67.0 |
| أتمتة العمليات التجاريةAutomationBench | 51.3 | 41.4 | 31.4 | 42.5 |
| التحليل الماليVals Finance Agent v2 | 65.4 | 53.5 | 58.9 | 58.6 |
| العمل القانونيHarvey Legal Agent | 19.6 | 5.4 | 6.7 | 3.8 |
| البرمجة | ||||
| البرمجة في مشاريع طويلة قاسته GoogleDeepSWE v1.1 | 77.9 | 74.1 | 67.4 | 74.2 |
| مهام برمجة طويلة وجديدةFrontierSWE v2 | 55.0 | 65.5 | 56.3 | 62.3 |
| بناء تطبيق من وصفVibe Code Bench | 91.9 | 89.6 | 90.3 | 90.3 |
| العمل في سطر الأوامر قاسته GoogleTerminal-Bench 4.0 | 57.4 | 58.2 | 57.9 | 66.4 |
| تدريب النماذج قاسته GooglePostTrainBench | 45.3 | 44.3 | 40.2 | 49.3 |
| العلوم والرياضيات | ||||
| العلوم في سطر الأوامر 6 أضعاف وقت الاختبارTerminal-Bench Science | 57.6 | 68.1 | 52.6 | 63.3 |
| البحث البيولوجي قاسته GoogleLABBench 2 | 88.8 | 85.4 | 68.6 | 73.1 |
| رياضيات بحثيةRiemannBench | 76.0 | 72.0 | 65.6 | 69.6 |
| المستندات الطويلة والحاسوب والصورة | ||||
| إيجاد معلومة في نص حتى 128 ألف توكن قاسته GoogleGraphWalks | 99.7 | 98.7 | 91.4 | 90.6 |
| إيجاد معلومة في نص من 256 ألفًا إلى مليون توكن قاسته GoogleGraphWalks | 84.2 | 71.8 | 65.0 | 66.8 |
| مهام وكيل طويلة على الحاسوب قاسته GoogleAgent's Last Exam | 39.5 | 34.2 | — | 38.2 |
| تشغيل الحاسوب الأفضل من 3 محاولاتOSWorld-2.0 | 69.2 | 72.6 | — | — |
| قراءة الرسوم البيانيةChartography | 71.6 | 71.0 | 46.2 | 66.3 |
| فهم الفيديوهات الطويلة ظروف مختلفة لكل نموذجLVBench | 91.7 | 87.5 | 79.7 | 83.7 |
| اكتشاف الثغرات الأمنية في الكودCWE-bench v1 | 68.0 | 68.0 | 58.0 | 67.0 |
الدرجة الأعلى في الصف. "قاسته Google": شغّلت Google نموذج Argon بنفسها، وأحيانًا المنافسين أيضًا. معظم درجات المنافسين أخذتها Google مما أعلنته الشركات المطوّرة نفسها. المصدر: إعلان الإطلاق من Google ووثيقة منهجية القياس. الترجمة والتمييزات من عندنا.
على الورق هذا فوز واضح. لكن حين نقرأ وثيقة منهجية القياس التي نشرتها Google إلى جانب الجدول، تتغيّر الصورة بثلاثة أمور.
الأول: بعض الظروف مريحة لـArgon. في تشغيل الحاسوب، درجة Argon هي الأفضل من بين ثلاث محاولات. وفي اختبار العلوم في سطر الأوامر حصل على 6 أضعاف وقت الاختبار المعتاد. وفي فهم الفيديو رأى كل نموذج عددًا مختلفًا من اللقطات من الفيديو. كل واحد من هذه مكتوب في الوثيقة، ولا شيء منها مكتوب في الجدول.
الثاني: منافسان غائبان. Claude Sonnet 5.5 وGPT-6.1 Sol يكلّفان مثل Argon بسعر الإطلاق، دولاران و10 دولارات (في Sol حتى 272 ألف توكن من المدخلات)، وكلاهما غائب عن الجدول. بل إن Sonnet 5.5 ينال درجة أعلى في مؤشر Artificial Analysis: 56 مقابل 53. من يختار نموذجًا بحسب السعر عليه أن يقارن Argon بهما تحديدًا.
الثالث: أين يخسر Argon. من بين أربعة اختبارات برمجة يخسر في اثنين: FrontierSWE، حيث المهام طويلة وجديدة، وTerminal-Bench. لم تكتب Google في أي مكان "أفضل نموذج في العالم"، لكنها كتبت أن Argon "يتفوّق على نماذج رائدة أخرى في الاختبارات في كل المجالات". هذا الجزء لا يصمد حين ننظر إلى البرمجة.
ماذا تقول الجهات المستقلة
جدول الشركة المصنِّعة يشبه شهادة اختار فيها الطالب بنفسه أي الدرجات يضع فيها وأمام من. ولكي نعرف أين يقف Argon فعلًا، نحتاج إلى جهات تشغّل كل النماذج في الظروف نفسها. هذا هو المؤشر العام لإحداها:
مؤشر Artificial Analysis (الإصدار 4.3): درجة عامة، ومتى صدر النموذج
المصدر: Artificial Analysis، Intelligence Index v4.3، حتى 14 أكتوبر 2026. مستوى التفكير هو المدة التي "يفكّر" فيها النموذج قبل أن يجيب: تفكير أكثر يعني درجة أعلى وتكلفة أعلى أيضًا. قيس Argon في المستوى العالي (High)، وOpus 5.5 في المستوى الأقصى (Max). تواريخ الإطلاق من إعلانات الشركات المطوّرة.
في هذا المؤشر يأتي Argon بعد Opus 5.5 وSonnet 5.5، متعادلًا مع GPT-6 Astra وClaude Fable 5.1، اللذين صدرا في بداية سبتمبر. هذا مستوى جيد جدًا، لكنه ليس رأس الجدول.
وفي بقية المصادر المستقلة تنقسم الصورة بحسب نوع العمل:
أين يتصدّر Argon
- Arena، النصوص: المركز الأول، 1525 نقطة، في تصنيف أولي من نحو 4,900 صوت. يكتب الناس سؤالًا، ويتلقون إجابتين دون أن يعرفوا من أي نموذج، ويختارون. الأول أيضًا في اللغات غير الإنجليزية
- Vals Index: 68.9 مقابل 67.0 لـOpus 5.5، بنصف التكلفة
- APEX-Agents: مهام المحللين والمستشارين، 82.4 مقابل 73.5
- اختلاق أقل: حين لا يعرف الإجابة يختلقها في 15% فقط من الحالات، وهي أقل نسبة بين النماذج القوية في اختبار Artificial Analysis
أين يتأخر Argon
- Arena، بناء المواقع: المركز 8، 1680 نقطة مقابل 1820 لـOpus 5.5
- CursorBench: مهام برمجة داخلية لدى Cursor، 52.9 مقابل 56.0 لـOpus في مستوى High و57.8 في Max
- FrontierCode: اختبار برمجة جديد من Cognition، 47.6 مقابل 54.6
- مهام مهنية يحكم عليها خبراء: في اختبار GDPval-AA من Artificial Analysis، 1624 مقابل 1866 نقطة
المصادر: Arena (30 سبتمبر)، Vals AI (30 سبتمبر)، بيانات Epoch AI التي تشمل CursorBench وFrontierCode وAPEX-Agents (14 أكتوبر)، Artificial Analysis (14 أكتوبر).
النمط يتكرر: في الكتابة وفي المهام التجارية التي يمكن التحقق من إجابتها، يتصدّر Argon أو يقترب من القمة. وفي البرمجة وبناء الواجهات والمهام المهنية التي يحكم خبراء على جودتها، يتأخر. في القائمتين اختبارات جديدة وخاصة، فالفجوة إذن بحسب نوع العمل. ومع ذلك، تبرز في القائمة الحمراء اختبارات البرمجة الجديدة.
benchmaxxing: هل "تدرّب Argon على الامتحان"؟
benchmaxxing تسمية لنموذج دُرّب بحيث يتفوّق تحديدًا في الاختبارات المعروفة. للتوضيح: طالبان ينالان العلامة الكاملة في اختبار SAT الأمريكي. أحدهما درس المادة، والآخر حلّ كل امتحانات السنوات السابقة. في الامتحان التالي، بأسئلة لم يرياها من قبل، سيظهر الفرق بينهما. والدقة مهمة هنا: هذا ليس غشًا. إنه قرار بشأن أين يُستثمر التدريب، والنتيجة نموذج يبدو في الجدول أفضل مما يبدو في العمل.
في 30 سبتمبر، يوم الإعلان، أفادت Bloomberg بأن موظفين في Google يقولون هذا بالضبط عن Argon: إنه يحقق درجات جيدة في الاختبارات، ويكون أقل جودة حين يُترك ليعمل، خصوصًا في تصميم الواجهات. وبحسب التقرير، قال شخصان مطّلعان على النموذج إن Gemini 4 "يبدو متأثرًا" بهذه العملية. وقالت Google إنه "ليس من الدقيق القول إن Gemini 4 متأخر في مجالات مثل البرمجة"، ونشرت رقمًا داخليًا: لدى مهندسيها، كود أكثر بنسبة 35% كتبه وكلاء ذكاء اصطناعي، وتغييرات أُلغيت أقل بنحو الثلث.
اختبار طائر البجع
اختبار طائر البجع الذي يجريه Simon Willison اختبار غير رسمي قديم: "ارسم طائر بجع يركب دراجة هوائية"، بكود ملف SVG. كل نموذج جديد يخضع له، والنتيجة الجيدة تنتشر بسرعة. أخرج Argon رسمة بجع ممتازة، بتكلفة 17 سنتًا.
Willison نفسه لا يدّعي أن Google درّبت Argon على اختبار البجع. لكنه يشير إلى أن Google، بحسب علمه، هي المختبر الوحيد الذي استثمر موظفوه جهدًا خاصًا في رسومات SVG. وفي نقاش على Hacker News تساءل بعض المعلّقين هل "احترق" الاختبار. هذا حال كل اختبار مشهور: حين يعرفه الجميع، يقيس أقل.
الفحص الذي أجريته: في أي شهر يقف Argon؟
لكي أفحص إحساسي بأن طيور البجع ليست كل شيء، أخذت أحدث أربعة اختبارات برمجة فيها نتيجة لـArgon، وفحصت من يتجاوز وأمام أي نموذج يخسر. التاريخ هو موعد صدور النموذج:
أربعة اختبارات برمجة جديدة: بين أي النماذج يقع Argon
| الاختبار ودرجة Argon | أين يقع |
|---|---|
| Arena، بناء المواقع · 1680 | تحت Claude Opus 5 من يوليو (1687)، فوق Kimi K3 من يوليو (1674) |
| FrontierCode · 47.6 | ملاصق لـGrok 4.7 من سبتمبر (47.6) ولـGPT-5.6 Sol من يوليو (47.5)، تحت Claude Fable 5 من يونيو (53.5) |
| FrontierSWE · 55.0 | تحت Claude Fable 5.1 من سبتمبر (56.3)، فوق Claude Opus 5 من يوليو (52.0) |
| CursorBench · 52.9 | تحت Claude Sonnet 5.5 من سبتمبر (55.5)، فوق Claude Fable 5.1 من سبتمبر (51.8) |
المصدر: بيانات Epoch AI، التي تجمع لوحات Arena وCognition وProximal وCursor (نُزّلت في 14 أكتوبر 2026). كل نموذج في أفضل إعداد قيس له. في FrontierCode شغّلت كل شركة نموذجها في أداة مختلفة، فالمقارنة ليست مضبوطة تمامًا.
في اثنين من الاختبارات الأربعة، بناء المواقع وFrontierCode، يقع Argon تحت Claude Opus 5 من أواخر يوليو، وفي مستوى نماذج من منتصف يوليو. وفي FrontierCode هو حتى تحت Claude Fable 5 من يونيو. أي أنه في البرمجة وتصميم الواجهات يقف Argon حيث كانت النماذج الرائدة قبل نحو ثلاثة أشهر، وهذا يتفق مع ما أراه في الأمثلة. وفي الاختبارين الآخرين هو أقرب، في مستوى سبتمبر.
وما الذي يناقض الشبهة
ليست كل الأدلة في الاتجاه نفسه:
- Arena اختبار يصعب جدًا التدرّب عليه. الأسئلة يكتبها أشخاص من جديد كل يوم، وArgon الأول هناك في النصوص. من جهة أخرى، Arena يقيس ما يفضّل الناس قراءته، ويمكن لنموذج أن يتعلّم كتابة إجابات يُستحسن اختيارها. كتب الباحث Teortaxes أن Argon ربما "مُكيَّف مع بيانات التفضيل"، وأن درجاته في الاختبارات التي يصعب التدرّب عليها لافتة.
- في الاختبارات الجديدة غير البرمجية Argon قوي. هو الأول في APEX-Agents (مهام المحللين والمستشارين) وفي Blueprint-Bench 2 (التفكير المكاني)، وفي Vending-Bench 2 (إدارة نشاط تجاري محاكى) يتجاوز Opus 5.5، وإن لم يتجاوز GPT-6 Astra.
- Leon Lin، الذي اختبر Argon قبل الإطلاق، كتب أنه "ليس benchmaxxed كما يظن كثيرون"، وفي التغريدة نفسها أنه ليس جيدًا في الواجهات والرسوم المتحركة، و"لا ذوق له".
تغريدة Leon Lin على X، 13 أكتوبر 2026
استنتاجي من البيانات: الـbenchmaxxing لا يغطي النموذج كله. هو يفسّر أساسًا الفجوة بين ادعاءات Google في البرمجة وبين ما يحدث في اختبارات البرمجة الجديدة وفي العمل نفسه. أما في الكتابة والمهام التجارية ذات الإجابة الواضحة فـArgon قوي فعلًا، حتى في الاختبارات التي يصعب التدرّب عليها.
أمثلة من الميدان: Argon مقابل Opus 5.5
في أول 24 ساعة شغّل مطوّرون الطلب نفسه على النموذجين. إليكم تجربتين لصالح Argon، وواحدة لصالح Opus، وتقريرًا واحدًا عن حصة الاستخدام.
مصباح حمم، 18 سنتًا مقابل 1.27 دولار. يشغّل BridgeMind على كل نموذج مهمة ثابتة: بناء مصباح حمم ثلاثي الأبعاد. أنهى Argon في أقل من دقيقتين، بـ18 سنتًا، بزجاج نظيف وحمم حقيقية. أما Opus 5.5 فعمل 9 دقائق ونصفًا، بـ1.27 دولار.
تغريدة BridgeMind والفيديو على X، 13 أكتوبر 2026
الطلب نفسه، 1.2 مقابل 8.2 دولار. أعطى المطوّر J A Z I I النموذجين الطلب نفسه، بأعلى مستوى تفكير. بحسب قوله، جاءت النتائج "شبه متطابقة"، وكلّف Argon نسبة 15% من السعر.
تغريدة notjazii وفيديو المقارنة على X، 13 أكتوبر 2026
البرمجة وعمل الوكلاء: Opus متقدم. كتب المصمم jumperz أنه أُعجب بما يفعله Argon مع المرئيات والمستندات المعقدة، لكن في البرمجة وعمل الوكلاء "Opus ما زال متقدمًا عليه بكثير"، وأنها ليست قفزة كبيرة بما يكفي.
تغريدة jumperz على X، 13 أكتوبر 2026
حصة أسبوع في نصف ساعة. شغّل ashen_one ثلاثة اختبارات بسيطة، منها استنساخ للعبة Minecraft، وكتب أن النتائج "ليست مذهلة"، وأن الاختبارات استنفدت كل حصته الأسبوعية في اشتراك بـ100 دولار شهريًا خلال 30 دقيقة. ولمن يفكّر في الاشتراك: لم تنشر Google مقدار استخدام Argon الذي تشمله كل باقة.
تغريدة ashen_one على X، 13 أكتوبر 2026
على Hacker News، في سلسلة نقاش الإطلاق، الصورة مشابهة. كتب بعض المعلّقين أن Opus 5.5 هو "أفضل نموذج برمجة بالإجماع"، وأشاد آخرون بـArgon لتفكيره الواضح والمباشر ولسرعته. وأفاد بعضهم بأعطال في اليوم الأول: حلقات تفكير لا تنتهي وأخطاء في الخادم.
كم يكلّف Argon فعلًا: الخُمس، الثلث، أم مثل Opus
الادعاء بأن Argon ينجز العمل نفسه بخُمس سعر Opus صحيح في بعض الحالات. كل شيء يتوقف على نوع المهمة وعلى التاريخ:
تكلفة Argon كنسبة من تكلفة Claude Opus 5.5 للعمل نفسه
المصادر: BridgeMind وnotjazii على X وOhMyUnicorn (13 أكتوبر)، Artificial Analysis (14 أكتوبر)، Vals AI (30 سبتمبر)، Cursor (14 أكتوبر). في CursorBench يُقطع الشريط عند 100%: كلّف Argon هناك أكثر من Opus.
ثلاثة أمور يُظهرها الرسم:
- في البناء المرئي لمرة واحدة الفجوة كبيرة. في تجربتين كلّف Argon نحو سُبع Opus، وفي الثالثة، تجربة OhMyUnicorn، نحو 60%. Argon ينهي بسرعة ويتوقف. أما Opus فيواصل الصقل، وفي تجربة OhMyUnicorn فحص الصفحة التي بناها ثلاث مرات.
- في العمل الواسع، يكلّف Argon نحو الثلث بسعر الإطلاق، ومن النصف إلى الثلثين بسعر ديسمبر. قيس Opus هناك في مستوى Max المكلف. وبحسب Artificial Analysis، يأتي التوفير أساسًا من انخفاض سعر التوكن. يستهلك Argon نحو 62 ألف توكن من المخرجات لكل مهمة، أي نصف Opus، لكن 2.3 ضعف GPT-6 Astra.
- في البرمجة المعقدة قد يختفي التوفير. في CursorBench كلّف Argon 4.57 دولار للمهمة، مقابل 3.97 لـOpus 5.5 في مستوى تفكير مشابه. وكتبت Cursor نفسها أن Argon في هذا الاختبار "في مستوى Opus 5.5"، وهو فعلًا قريب في الدرجة، أقل بنحو 3 نقاط.
والتاريخ الذي يجدر تدوينه: 30 نوفمبر. حتى ذلك اليوم يكلّف Argon دولارين لكل مليون توكن من المدخلات و10 دولارات للمخرجات، مثل Claude Sonnet 5.5 وGPT-6.1 Sol. وابتداءً من 1 ديسمبر يرتفع السعر إلى 4 و20، وهو بالضبط سعر Opus 5.5. من يبني اليوم عملية على Argon بسبب السعر، عليه أن يحسبها منذ الآن بسعر ديسمبر.
أين تتصدّر Google فعلًا
هذا ليس مقالًا ضد Google. هناك مجالات تكون فيها Google، في رأيي، قوية بشكل خاص، وهي أهم لمعظم الشركات من اختبارات البرمجة:
لغة طبيعية بأي لغة
- Argon الأول في Arena في اللغات غير الإنجليزية أيضًا، وبشكل منفصل في الروسية والصينية
- كتابة نماذج Gemini التي عملت معها تبدو ككتابة إنسان، لا كترجمة. هذا انطباعي الشخصي
- في العبرية والعربية لا يوجد قياس منظّم بعد، فالأفضل أن تفحصوه على نصوصكم
عائلة تفعل كل شيء
- الصور في Nano Banana، والفيديو والصوت والموسيقى، كلها لدى الشركة نفسها
- Argon يكتب الكود وينسّق بين بقية النماذج
- فهم الفيديو: 91.7 في LVBench، بحسب قياس Google
اختلاق أقل
- حين لا يعرف، يختلق في 15% فقط من الحالات، مقابل أكثر من 50% في نماذج GPT-6
- يعرف حقائق أقل من Opus، لكنه يعترف حين لا يعرف
- مهم لوكيل يردّ على العملاء. ما هي هلوسة الذكاء الاصطناعي
مستندات طويلة
- نافذة من مليون توكن بلا زيادة في السعر على المستندات الطويلة
- في جدول Google يتصدّر في إيجاد المعلومات في نص طويل جدًا، لكن في الاختبار المستقل AA-LCR يتقدّم Opus: 85 مقابل 80
- أفاد مستخدم واحد بأن أداة Copilot تختصر المحادثة عند نحو 400 ألف توكن
رأيي: لماذا ما زالت Google متأخرة رغم كل مواردها
هنا أنتقل من الحقائق إلى التفسير.
Argon تحسّن حقيقي، ولا أظن أن Google كذبت. لكني أظن أنها قدّمته كنموذج يقود العالم، وهذا ليس الواقع. وشخصيًا، حين تعرض شركة أرقامًا لا تصمد في الميدان، تتراجع ثقتي بها. في الجدول القادم من Google سأقرأ وثيقة منهجية القياس أولًا، وبعدها فقط الجدول.
أنا أؤمن بـGoogle. لديها الباحثون والرقائق والبيانات ومليارات المستخدمين. ولهذا تحديدًا يجدر السؤال لماذا ما زالت متأخرة. جوابي: Google شركة مساهمة عامة، في مجال جديد وخطير.
- الضغط لإظهار النتائج. لدى Alphabet التزامات تجاه المستثمرين، وكل إطلاق يُقاس في البورصة أيضًا. بحسب Bloomberg، ارتفع السهم بنحو 1.7% في التداول الذي تلا الإعلان، ثم محا جزءًا من الارتفاع بعد التقرير عن تشكّك الموظفين. وحين يتفاعل السوق مع الجدول، يكون هناك حافز قوي لاختيار الاختبارات والمنافسين الذين يُظهرونها بصورة جيدة.
- حرية أقل في التحرّك بسرعة. بصفتي مشتركًا، رأيت Anthropic وOpenAI تغيّران عدة مرات مقدار الاستخدام الذي يحصل عليه كل مشترك. في يونيو رُفعت ضد Anthropic دعوى تسعى لأن تكون دعوى جماعية، بزعم أن حصص الاستخدام في اشتراكات Max أقل مما أُعلن. هذه ادعاءات لم يُفصل فيها بعد. في رأيي، قد تكلّف خطوة كهذه شركة مساهمة عامة بحجم Google دعوى جماعية بالمليارات، ولذلك هي مقيّدة أكثر في كل خطوة. وأقدّر أن الحذر نفسه يعمل في السلامة أيضًا.
- السلامة. فتحت Google نموذج Argon أولًا لمجموعة مغلقة من المدافعين في الأمن السيبراني. في مجال كالأمن السيبراني هذا قرار صائب، لكنه يكلّف وقتًا، والمنافسون الأصغر يتحرّكون أسرع.
وعن تأخير الأسبوعين لديّ فرضية إضافية: أن المجموعة الأولى التي عملت مع النموذج رأت أن النتائج في الميدان أقل جودة مما يعد به الجدول. ليس لديّ مصدر لذلك. تفسير Google الرسمي هو السلامة فقط، وهذا إحساسي لا حقيقة. أما الموثّق فهو: Gemini 3.5 Pro، الذي وُعد به في يونيو، أُلغي، وقال موظفون في Google لـBloomberg إن Argon أضعف في العمل منه في الاختبارات. هذا التقرير نُشر يوم الإعلان، ولذلك لا يفسّر التأخير نفسه.
أين يقع Argon في Sigma AI Ranking
دخل Argon إلى Sigma AI Ranking في 13 أكتوبر بوسم "درجة أولية"، لأن مصدرًا واحدًا فقط، Arena، قاسه. وفي تحديث 14 أكتوبر دخل السعر، واختبار المعرفة من Epoch AI، وتصنيفات Arena الكاملة، فنال درجة كاملة. النتيجة ستفاجئ على الأرجح من قرأ حتى هنا:
Sigma AI Ranking: درجة مرجّحة، حتى 14 أكتوبر 2026
المصدر: Sigma AI Ranking من Platin Digital، الذي يرجّح مصادر مفتوحة (Epoch AI وArena وTerminal-Bench وقوائم الأسعار الرسمية). بحسب قواعد التصنيف، الفارق الأقل من نقطتين عن المتصدّر يُعدّ تعادلًا.
Argon في المركز الثاني، بفارق 0.9 نقطة عن Opus 5.5، وبحسب قواعدنا هذا تعادل في القمة. لم نغيّر المنهجية لتناسب النتيجة رأيي، ولذلك من المهم شرح ما يقف وراء الرقم:
- الكتابة والموثوقية تأتيان من Arena. هناك Argon الأول، لأن الناس يفضّلون إجاباته. هذه قوته الحقيقية، وهي أيضًا الموضع الذي تكون فيه شبهة "التكيّف مع بيانات التفضيل" ذات صلة.
- درجته كوكيل تقديرية. ليس لـArgon بعد نتيجة في Terminal-Bench، مصدرنا الرئيسي لعمل الوكلاء والبرمجة، ولذلك حُسبت الدرجة من مصادر موازية ومُيّزت بـ≈ في الصفحة. ودرجته في القدرة العامة تقديرية أيضًا، لأن Epoch AI لم تنشر له بعد مؤشرها العام. ولم يدخل الحساب أي من اختبارات البرمجة الجديدة من القسم عن benchmaxxing، لأنها ليست بترخيص مفتوح.
- السعر هو سعر الإطلاق. يحسب التصنيف التكلفة بحسب السعر الحالي، دولاران و10 دولارات. وبحسب حسابي، في 1 ديسمبر، حين يتضاعف السعر، سينزل Argon إلى نحو 88.3 ويخرج من التعادل.
بعبارة أخرى، يُظهر Sigma بالضبط ما يصفه المقال: في المصادر التي تقيس الكتابة والمعرفة والسعر Argon في القمة، وفجوته تقع حيث لا تغطّي المصادر المفتوحة بعد. وحين تُنشر نتيجة في Terminal-Bench، ستتحدّث الدرجة. لماذا بنينا تصنيفًا خاصًا بنا، ولماذا يعتمد على مصادر مفتوحة فقط، شرحناه في المقال عن Sigma AI Ranking.
لمن يصلح Gemini 4 Argon، ولمن لا يصلح بعد
يصلح
- الكتابة والمحتوى، خصوصًا بلغات غير الإنجليزية
- تلخيص وتحليل المستندات الطويلة والفيديوهات والرسوم البيانية
- العمل المكتبي والمالي ذو النهاية الواضحة
- وكيل يردّ على العملاء، حين يهمّ ألا يختلق إجابات
- البناء المرئي السريع، حين تكفي مسودة جيدة
افحصوا أولًا
- كل عملية بُنيت بسبب السعر: ابتداءً من 1 ديسمبر يتضاعف
- الاشتراك في التطبيق: لا رقم رسميًا لمقدار استخدام Argon الذي يشمله
- العربية: لا يوجد اختبار منظّم بعد، بل انطباعات فقط
ليس بعد
- تطوير البرمجيات المعقد والعمل الطويل على كود قائم
- تصميم الواجهات والمواقع، حيث الذوق هو المنتج
- مهمة تحسم فيها الجودة أكثر من السعر
Argon أم Opus 5.5 لمهمتكم القادمة؟
خمسة أسئلة عن مهمة واحدة تفكّرون فيها. بعد النتيجة، شغّلوا المهمة مرة واحدة على النموذجين وراجعوا الفاتورة.
أربعة أمور تُقال عن Argon، وما الصحيح منها
خرافة"Google تتصدّر الجدول، إذن هذا أفضل نموذج في العالم"
في الواقعيتصدّر Argon في 13 من أصل 19 صفًا في جدول Google. وفي المؤشر المستقل لـArtificial Analysis ينال 53، مقابل 58 لـClaude Opus 5.5 و56 لـClaude Sonnet 5.5.
خرافة"Argon يكلّف خُمس Opus"
في الواقعفي تجربتين للبناء المرئي، أقل من ذلك أيضًا. في العمل الواسع، نحو الثلث بسعر الإطلاق. وفي البرمجة المعقدة قد يكلّف أكثر. وابتداءً من 1 ديسمبر يصبح سعر التوكن مطابقًا لـOpus 5.5.
خرافة"benchmaxxing غش"
في الواقعهو اختيار بشأن أين يُستثمر التدريب. النموذج يعرف فعلًا أن يؤدي ما يفحصه الاختبار، لكن الدرجة تعكس بدرجة أقل ما سيفعله في مهمة جديدة.
خرافة"Argon يولّد صورًا وفيديوهات"
في الواقعArgon يُخرج نصًا وكودًا فقط. الصور والصوت والموسيقى تنتجها نماذج أخرى من Google، يعرف Argon كيف يشغّلها.
ماذا يعني ذلك لأصحاب الأعمال
ثلاثة استنتاجات عملية:
- هناك الآن ثلاثة نماذج قوية بنصف سعر التوكن في Opus: Claude Sonnet 5.5 وGPT-6.1 Sol بشكل دائم، وArgon حتى نهاية نوفمبر. لمهام الكتابة والمستندات وخدمة العملاء بلغات غير الإنجليزية، Argon مرشّح جدّي. هذا وقت تجربته.
- لا تختاروا نموذجًا بحسب جدول الشركة المصنِّعة. اقرأوا من قاس كل صف وفي أي ظروف، وجرّبوا على مهمة حقيقية واحدة من عملكم، مع ساعة ومع فاتورة. كتبت عن ذلك أيضًا في المقال عن Muse Wonder من Meta: هناك أيضًا روى جدول الشركة قصة مختلفة عن تجارب الميدان.
- اختاروا النموذج بحسب المهمة، لا بحسب الشركة. خلال ثلاثة أشهر تبدّلت الأداة المتصدّرة مرتين، كما وصفت في المقال عن عودة Anthropic. الوكيل الجيد يمكنه أن يعمل مع Argon في الكتابة ومع Opus في البرمجة.
Platin Digital هي OpenAI Select Partner، والوكلاء الذين نُنشئهم نبنيهم بالنماذج والأدوات الأنسب لكل نشاط تجاري، من OpenAI وAnthropic وGoogle وغيرها. دخل Argon لدينا مرحلة التجربة في الكتابة وفي العمل بلغات غير الإنجليزية. أما للبرمجة وللعمل الذي تحسم فيه الجودة، فأبقى في الوقت الحالي مع Opus 5.5.
لمزيد من القراءة: Gemini at Work 2026: وكيل Google للأعمال، وChatGPT أم Gemini أم Claude لشركتكم، ولماذا بنينا Sigma AI Ranking.
الأسئلة الشائعة
ما هو Gemini 4 Argon؟
Gemini 4 Argon هو النموذج الكبير في عائلة Gemini 4 من Google، أُعلن عنه في 30 سبتمبر 2026 وأُتيح للجميع في 13 أكتوبر. يستقبل النصوص والصور والصوت والفيديو وملفات PDF، ويُخرج نصًا، ولديه نافذة سياق من مليون توكن. وهو مخصص للتفكير المعقد، وللعمل مع المستندات، ولعمل الوكلاء.
كم يكلّف Gemini 4 Argon؟
عبر API، حتى 30 نوفمبر 2026: دولاران لكل مليون توكن من المدخلات و10 دولارات لكل مليون توكن من المخرجات. وابتداءً من 1 ديسمبر: 4 و20 دولارًا، مثل Claude Opus 5.5. لا توجد باقة مجانية. وفي تطبيق Gemini هو متاح لمشتركي Google AI Pro وUltra، ولم تنشر Google مقدار استخدام Argon الذي يشمله كل اشتراك.
هل Gemini 4 Argon أفضل من Claude Opus 5.5؟
في جدول Google، يفوز Argon على Opus 5.5 في 14 من أصل 18 اختبارًا قيس فيها كلاهما. وفي المؤشر المستقل لـArtificial Analysis يتصدّر Opus 5.5 بـ58 مقابل 53. Argon يتصدّر في الكتابة وفي المهام التجارية التي يمكن التحقق من إجابتها. وOpus 5.5 يتصدّر في البرمجة وبناء الواجهات والمهام المهنية التي يحكم عليها خبراء، حتى في الاختبارات الجديدة والخاصة.
ما هو benchmaxxing؟
benchmaxxing تسمية لنموذج دُرّب بحيث يتفوّق خصوصًا في الاختبارات المعروفة التي تنشرها كل الشركات. الدرجة في هذه الاختبارات عالية، لكن النتيجة في المهام الجديدة أقل جودة. هذا ليس تزييفًا للنتيجة، بل اختيار بشأن أين يُستثمر التدريب. والطريقة لاكتشافه هي المقارنة بين الاختبارات المعروفة والاختبارات الجديدة أو الخاصة.
هل Gemini 4 Argon جيد بالعربية؟
لا يوجد بعد اختبار منظّم لـArgon بالعربية، ولا بالعبرية. أقرب رقم هو Arena، حيث Argon في المركز الأول في اللغات غير الإنجليزية. ومن تجربتي مع Gemini بالعبرية، اللغة التي أعمل بها، كتابته أكثر طبيعية من كتابة معظم النماذج، لكن هذا انطباع لا قياس.
لماذا لم تفتح Google نموذج Argon للجميع إلا بعد أسبوعين؟
بحسب Google، لأسباب تتعلق بالسلامة: إطلاق على مراحل، أولًا للمدافعين في الأمن السيبراني ضمن برنامج Fairwind، ومشاركة في برنامج لحكومة الولايات المتحدة للوصول المبكر إلى النماذج. وفي وثيقة النموذج تذكر Google أنها لا تستطيع أن تستبعد أن النموذج تجاوز عتبتها الحرجة لقدرات الأمن السيبراني. وفي 13 أكتوبر أُتيح للمطوّرين ولمشتركي Pro وUltra.
المصادر
- https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
- https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-argon/
- https://storage.googleapis.com/deepmind-media/Model-Cards/Gemini-4-Argon-Model-Card.pdf
- https://storage.googleapis.com/deepmind-media/gemini/gemini_4_argon_model_evaluation.pdf
- https://storage.googleapis.com/deepmind-media/gemini/gemini_4_safety_report.pdf
- https://ai.google.dev/gemini-api/docs/pricing
- https://ai.google.dev/gemini-api/docs/models/gemini-4-argon
- https://gemini.google/release-notes/
- https://platform.claude.com/docs/en/about-claude/pricing
- https://developers.openai.com/api/docs/pricing
- https://artificialanalysis.ai/articles/gemini-4-argon-google-top-three-labs
- https://artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-opus-5-5
- https://x.com/ArtificialAnlys/status/2105392625788637299
- https://www.vals.ai/models/google_gemini-4-argon
- https://epoch.ai/data/benchmark_data.zip
- https://cursor.com/cursorbench
- https://www.frontierswe.com/
- https://cognition.com/frontiercode
- https://x.com/arena/status/2105394855644139908
- https://simonwillison.net/2026/Oct/13/llm-gemini/
- https://news.ycombinator.com/item?id=50073879
- https://x.com/bridgemindai/status/2110050421184360718
- https://x.com/notjazii/status/2110073240404271335
- https://x.com/jumperz/status/2110064835270689125
- https://x.com/LexnLin/status/2110057390259290540
- https://x.com/ashen_one/status/2110055018191565201
- https://x.com/bindureddy/status/2110038264463987088
- https://x.com/cursor_ai/status/2110087611763368271
- https://x.com/teortaxesTex/status/2105455812915433849
- https://ohmyunicorn.com/labs/dream-loop/planet-argon/
- https://andonlabs.com/evals/blueprint-bench-2
- https://artificialanalysis.ai/evaluations/omniscience
- https://www.thestar.com.my/tech/tech-news/2026/10/02/google-grapples-with-employee-scepticism-about-new-gemini-4
- https://venturebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release
- https://www.khaleejtimes.com/business/google-announces-gemini-4-flagship-ai-model-after-months-of-delays-2
- https://www.techzine.eu/news/applications/144960/opinions-are-divided-on-gemini-4-argon/
- https://www.engadget.com/2194626/anthropic-hit-with-lawsuit-over-its-claude-max-usage-limits/